 AI実装研究所 編集部
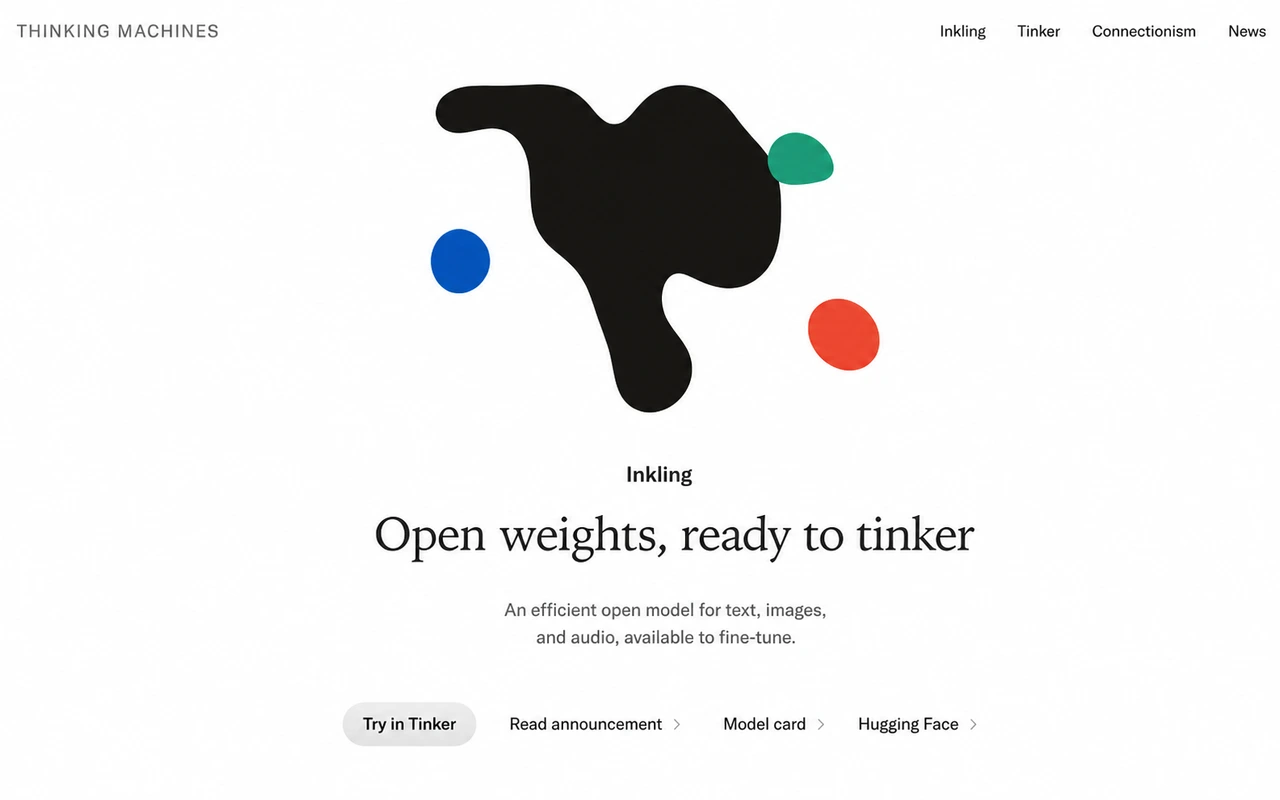
AI研究企業のThinking Machines Labは、2026年7月15日、自社が独自に学習させた初めての基盤モデル「Inkling」を発表した。同社は、OpenAIでCTO(最高技術責任者)を務めたミラ・ムラティ氏が共同創業者兼CEOを務める企業である。Inklingはテキストに加えて画像や音声も読み込めるマルチモーダル基盤モデルで、今回の発表の中心は、モデル本体のパラメータ(通称ウェイト)を、Apache 2.0ライセンス表記のもとHugging Faceで誰でも取得できる形にした点にある。大手AI企業の多くはモデルをAPI経由でしか使わせないため、パラメータそのものを手元に置ける公開の仕方は珍しい。
発表の内容と主要仕様
Inklingは、総パラメータ数9750億のうち、実際の処理では410億だけを動かすMoE(Mixture of Experts。内部に複数の専門家ネットワークを持ち、入力ごとにその一部だけを動かす構成)のモデルである。入力はテキスト、画像、音声に対応し、出力はテキストのみとなる。一度に読み込めるコンテキスト長は最大100万トークンとしている。
事前学習には、テキスト、画像、音声、動画を合わせた45兆トークンを使ったと公式発表は説明している。学習データの由来について、公式モデルカードは公開情報、第三者から取得したデータ、合成または加工したデータの3種類に分けて説明している。
公式発表は、Inklingが実際に扱える例として、音声の文字起こしや録音内容についての質問への回答、画像・グラフ・図表の読み取り、コーディング、外部ツールの操作を挙げている。テキストの入出力だけでなく、会議の録音や資料の図表を読ませる使い方までを見込んでいる点がうかがえる。
総合最強ではなく、追加学習の土台という位置づけ
公式発表は、Inklingをオープン・クローズドを問わず性能で最上位を狙うモデルとしては位置づけていない。Thinking Machines Labが掲げるのは、マルチモーダル対応、効率的な思考、そして後述する「Tinker」上での追加学習を組み合わせ、利用者が自分の用途向けに調整できる土台とする位置づけである。
Tinkerで動かすLoRAによる自己追加学習のデモ
Thinking Machines Labは、追加学習を扱うAPIサービス「Tinker」を提供している。Tinkerは、元のモデル全体を学習し直すのではなく、LoRA(Low-Rank Adaptation、モデル本体は固定したまま小さな追加部分だけを学習する手法)で調整する仕組みを持ち、学習ジョブのスケジューリングやリソース管理、分散GPU基盤の運用はサービス側が引き受ける。今回の公式発表では、Inkling自身がTinkerを使い、追加学習ジョブの作成から実行、評価、そして更新版への切り替えまでを行うデモが紹介されている。
調整できる思考量と、提供元ベンチマークの注意点
Inklingは、応答を生成する際にどれだけ「考える」かを調整できる設計になっているという。公式発表が示した評価では、Terminal Bench 2.1というベンチマークで、Nemotron 3 Ultraと同程度の成績を、生成トークン数にして約3分の1で達成したとしている。ただしこれはThinking Machines Lab自身が実施した評価であり、第三者による検証結果ではない点には注意が必要だ。
Hugging Faceでの入手経路と必要な計算環境
Inklingの全ウェイトは、Hugging Face上のThinking Machines Lab公式ページから取得できる。公開されているのは、通常のチェックポイントに加え、NVIDIA Blackwell向けに軽量化したNVFP4形式のチェックポイントの2種類である。ライセンスは、モデルカード上でApache 2.0と表記されている。
ただし、手元での実行には相応の計算環境が要る。公式モデルカードによれば、集約VRAM(複数のGPUをつなげた合計のメモリ容量)は、BF16版で2テラバイト以上、NVFP4版でも600ギガバイト以上が目安とされている。個人が自宅のパソコンで用意できる規模ではなく、GPUをまとまった数だけ確保できる環境が前提になる。
そうした環境を持たない場合の選択肢としては、Thinking Machines Lab自身の「Tinker」経由での利用と、外部推論プロバイダー経由でのAPI利用がある。Tinker上では64Kまたは256Kトークンのコンテキスト長で提供されるが、これはモデル自体が対応する最大100万トークンとは別の数字であり、混同すると想定より短い文章しか扱えないと誤解しかねない。
なお、モデル素材の利用には、Apache 2.0のライセンス表記とは別にModel Acceptable Use Policyが適用され、禁止用途や利用者への制約開示が定められている。
軽量版Inkling-Smallと未確定な点
軽量版として、総パラメータ数2760億、アクティブ120億のMoEモデル「Inkling-Small」も発表されているが、現時点ではプレビュー段階にとどまる。公式発表は、テストが完了した後に全ウェイトを公開するとしているが、公開時期は明言していない。
公式モデルカードは、英語を中心とした一般的な多言語対応を掲げる一方、言語や分野によって性能が不均一になり得るとも明記している。日本語など英語以外の言語で使う場合は、想定する用途に近い入力例を使って精度を事前に確認する必要がある。編集部ではInklingの実機検証を行っておらず、上記の性能や仕様、ベンチマークの数値はいずれもThinking Machines Lab自身による発表内容である。
企業利用で確認しておきたい点
全ウェイトの公開は、企業が自社データによる追加学習や外部サービスへの組み込みを検討する選択肢を新たに開くものでもある。検討する場合は、Model Acceptable Use Policyが定める禁止用途や制約開示の内容を確認したうえで、BF16なら2テラバイト以上、NVFP4でも600ギガバイト以上という集約VRAMの規模を踏まえて判断する必要がある。